第一讲:数据结构到底是什么?
假设我们正在开发一个游戏,游戏里有 100 个敌人,每个敌人有血量、攻击力和位置。
你可以用 C 语言存储:
struct Enemy {
    int hp;
    float attack;
    float x, y, z;
};

struct Enemy enemies[100];
这时候我们已经有了一个非常简单的数据结构:
数组 + 结构体。
但问题出现了。
如果我们想实现这些功能:
- 删除一个已经死亡的敌人。
- 在指定位置插入新的敌人。
- 查找血量最低的敌人。
- 按照敌人与玩家的距离排序。
那么,应该怎样组织这些数据,才能让程序运行得更快?
这就是数据结构要解决的问题之一。
数据结构不仅研究怎么存储数据,还研究数据之间有什么关系,以及怎样高效地操作它们。
1. 数据结构的三个核心内容
数据结构(组织、存储和处理数据)
- 逻辑结构(数据之间有什么关系)
- 存储结构(数据在内存里怎样放)
- 数据运算(怎样查找、插入、删除)
这里最容易混淆的是逻辑结构和存储结构。
例如,一个班级有四个学生,按照学号排列:
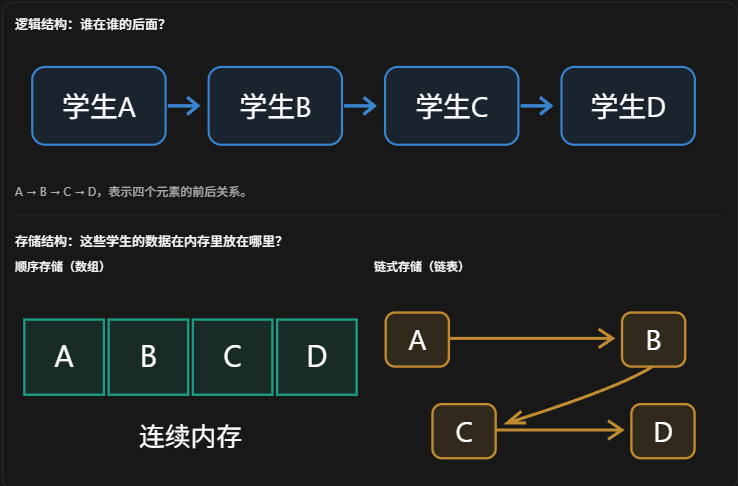
它们的逻辑顺序都是 A、B、C、D,但是在内存中的组织方式不同。
这就是为什么一本数据结构教材会同时讲线性表、顺序表、链表:它们不是三个完全独立的概念,而是不同层次的概念。
2. 为什么数据结构还要学习算法?
因为相同的数据,不同的处理方式,运行效率可能差距巨大。
例如,要从 100 万个整数里找到一个指定的数字。
- 普通顺序查找:最坏需要比较 100 万次。
- 如果数据已经排好序,使用二分查找:最多比较约 20 次。
这就引出了第一章另一个重要概念:时间复杂度。
在数据结构的书中会经常看到: 这样的东西
它们描述算法所需操作次数随数据规模增长的趋势,而不是直接表示运行了多少秒。-
第 2 讲:算法与时间复杂度
我们要解决一个问题:
为什么两段代码实现相同的功能,运行效率却可能相差几千倍?
一、什么是算法?
算法(Algorithm)是为解决特定问题而设计的一组有限、明确、可执行的步骤。
例如,我们有五名角色的生命值:
int hp[5] = {100, 80, 60, 120, 90};
要求找到生命值最高的角色。
int max = hp[0];
for (int i = 1; i < 5; i++)
 {
    if (hp[i] > max) {
        max = hp[i];
    }
}
程序的执行过程:
最后得到 max = 120
这个过程就是一个简单的查找算法。
教材中,算法通常具有五个重要特性:有穷性、确定性、可行性、输入和输出。
二、为什么需要时间复杂度?
假设有两个算法,都能完成查找任务。
算法 A 需要执行大约 次基本操作。
算法 B 需要执行大约 次基本操作。
当 时:
- 算法 A:10 次。
- 算法 B:100 次。
当 时:
- 算法 A:10000 次。
- 算法 B:100000000 次。
这就是时间复杂度要研究的事情:当输入规模 增大时,算法的操作次数以什么速度增长。
注意:时间复杂度不是程序的实际运行秒数,而是操作次数的渐近增长量级。
三、认识大 O 记号
教材里面会出现:
其中 表示算法的操作次数, 表示它的渐近上界。
例如:
当 很大时, 项占主导,因此:
严格地说,大 O 是上界记号,并不一定表示最紧的增长量级;通常教材会使用它来描述算法的主要增长趋势。
常见时间复杂度
四、通过 C 语言代码理解时间复杂度
例题 1:常数阶
int a = 10;
int b = 20;
int c = a + b;
不论有多少其他数据,这段代码的基本操作次数都不随 增长。
因此:
例题 2:线性阶
for (int i = 0; i < n; i++)
{
    printf("%d\n", i);
}
不论有多少其他数据,这段代码的基本操作次数都不随 增长。
因此:
例题 3:平方阶
for (int i = 0; i < n; i++)
{
    for (int j = 0; j < n; j++)
{
        printf("%d %d\n", i, j);
    }
}
外层执行 次,而每一次外层循环,内层又执行 次。
所以:
例题 4:对数阶
for (int i = 1; i < n; i *= 2)
{
    printf("%d\n", i);
}
注意这里不是i++,而是i *= 2。
每次循环,i 都翻倍:
1,2,4,8,16,32,.......
假设 。
循环运行 10 次,因为:
210 = 1024
因此:
大 O 记号通常省略对数底数,因为改变固定底数只会引入常数倍。
五、空间复杂度是什么?
时间复杂度研究操作次数的增长趋势。
空间复杂度研究算法使用的内存空间随 的增长趋势,通常重点分析额外辅助空间。
例如:
int sum = 0;

for (int i = 0; i < n; i++)
{
    sum += i;
}
这里不论循环执行多少次,额外使用的变量数量都不随 增长。
因此:
而如果创建一个长度与 成正比的辅助数组:
int *buffer = malloc(n * sizeof(int));
如果分配成功,就需要存储 个整数。
因此额外空间复杂度为:
在游戏引擎中,时间复杂度和空间复杂度都很重要。例如,实时渲染既需要控制每帧的 CPU 执行时间,也需要考虑内存占用和缓存访问效率。
第 3 讲:时间复杂度的计算方法
一、时间复杂度的基本计算规则
先看一个例子:
int sum = 0;

for (int i = 0; i < n; i++)
{
    sum += i;
}

printf("%d", sum);
分析算法复杂度时,通常关注基本操作的执行次数。
sum += i 执行了 次。
printf执行了 1 次。
因此,简化后的操作次数可以写成:
当 非常大时,常数 1 对增长趋势的影响可以忽略。
所以:
由此得到三个常用规则:
- 忽略常数项: 。
- 忽略常数系数: 。
- 保留最高阶项: 。
这些规则适用于分析渐近增长量级。
二、为什么双重循环不一定是 ?
看下面两段代码。
第一种:完整的双重循环
for (int i = 0; i < n; i++)
{
    for (int j = 0; j < n; j++)
   {
        printf("*");
    }
}
外层循环执行 次,每次内层循环也执行 次。
因此:
第二种:内层循环依赖外层变量
for (int i = 0; i < n; i++)
{
    for (int j = 0; j < i; j++)
   {
        printf("*");
    }
}
这次内层循环的条件变成了 j < i 。
当 时:
因此,总执行次数为:
利用等差数列求和公式:
展开:
保留最高阶项,忽略常数系数:
注意,虽然这两段代码的执行次数不同,但它们的渐近增长量级相同。
三、最容易看错的一类:循环变量成倍变化
int i = 1;

while (i < n)
{
    i = i * 2;
}
这里每次循环都让 i 翻倍。
一般情况下,经过 次循环:
循环结束时:
两边取对数:
所以循环执行次数约为:
这里的关键是:每次循环,剩余的规模按固定比例缩小,或者变量按固定倍数增长。
四、再难一点:不同循环结构的组合
下面这段代码:
for (int i = 0; i < n; i++)
{
    printf("A");
}

for (int j = 0; j < n * n; j++)
{
    printf("B");
}
第一个循环执行 次。
第二个循环执行 次。
因此:
最终得到:
但是如果把它改成嵌套循环:
for (int i = 0; i < n; i++)
{
    for (int j = 1; j < n; j *= 2)
   {
        printf("*");
    }
}
外层执行 次。
内层执行约 次。
因此:
最终:
这也是为什么归并排序等算法中会出现 的复杂度。
五、最好情况、最坏情况与平均情况
假设在数组中查找指定数字:
int search(int a[], int n, int target) {
    for (int i = 0; i < n; i++) {
        if (a[i] == target) {
            return i;
        }
    }

    return -1;
}
如果目标是第一个元素,只需要比较一次。
如果目标是最后一个元素,或者根本不存在,就需要比较 次。
因此:
平均情况需要明确概率模型,不能简单地把最好和最坏情况取平均。
在教材和考试中,如果题目没有特别说明,通常优先分析最坏情况时间复杂度,但具体仍取决于题目要求。